지난 글에서 지도학습의 큰 갈래를 봤다.
이번엔 가장 직관적인 지도학습 모델인 결정트리와, 그걸 여러 개 묶어 성능을 끌어올린 랜덤포레스트를 정리한다.
1. 결정트리 - 질문을 이어 가며 나눈다
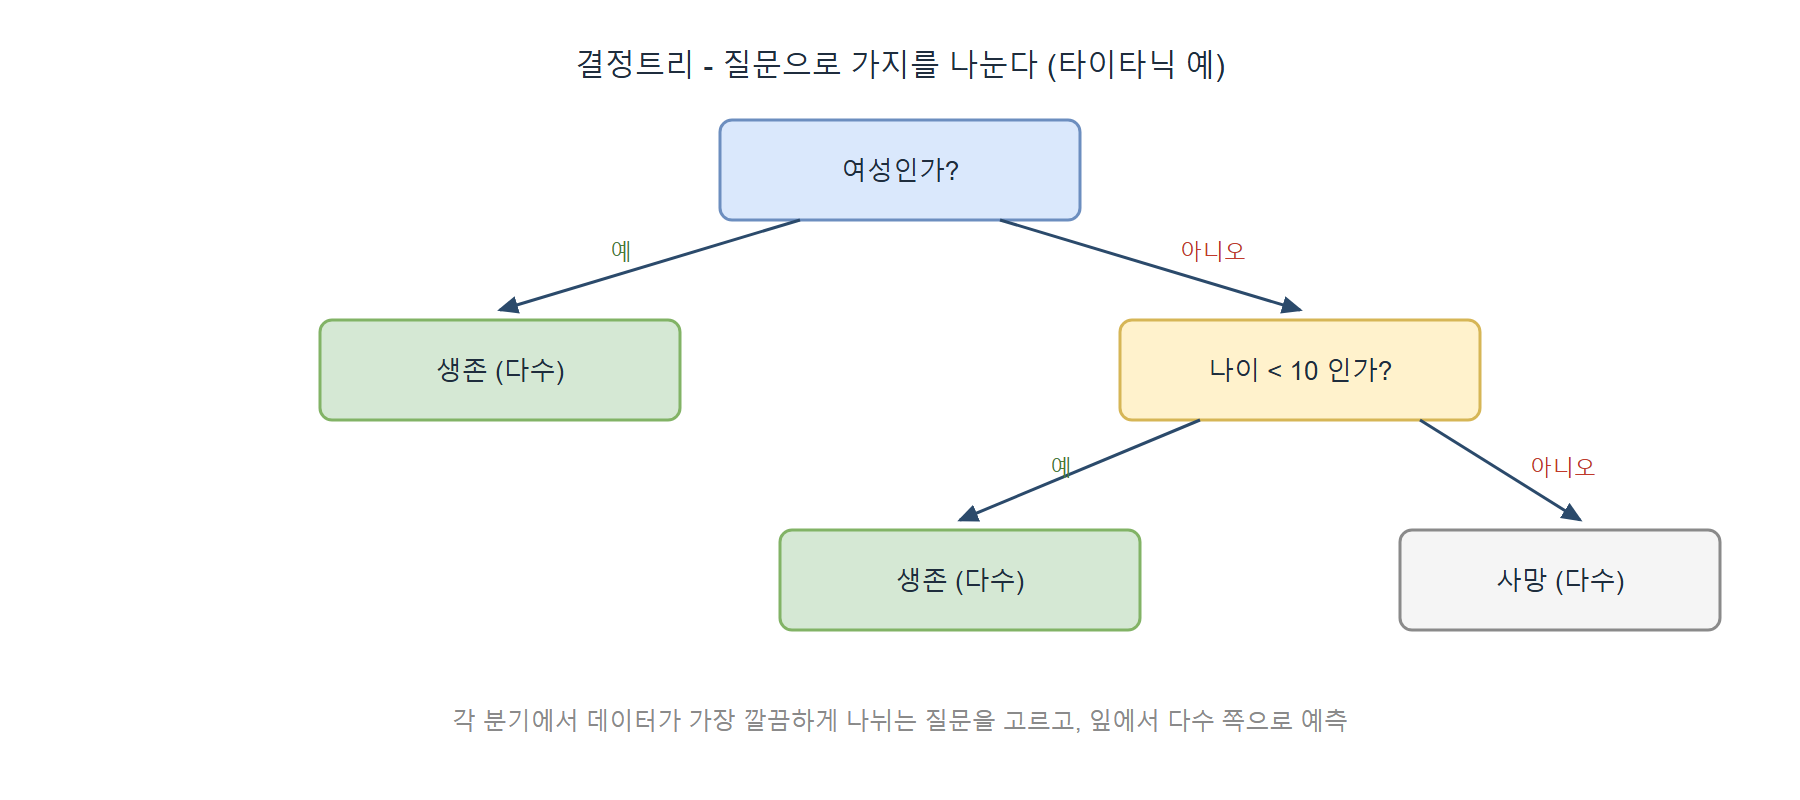
: 데이터를 "예/아니오" 질문으로 계속 쪼개 가며 답을 내는 모델임
: 예를 들어 타이타닉이면 "여성인가?" → "3등급인가?" → "나이가 10세 미만인가?" 식으로 가지를 침
: 각 질문(분기)에서 데이터가 가장 깔끔하게 둘로 나뉘는 기준을 고름
: 맨 아래 잎(leaf)에 도달하면 그 그룹의 다수 쪽으로 예측함
2. 무엇을 기준으로 나누나
: "깔끔하게 나뉜다"를 수치로 재는 기준이 필요함 - 불순도(impurity)
: 지니 불순도, 엔트로피 같은 값으로, 한 그룹에 한 종류만 모일수록 낮아짐
: 각 분기에서 불순도가 가장 많이 줄어드는 질문을 골라 가지를 침
: 사람이 규칙을 안 짜도, 데이터에서 "잘 나누는 질문"을 스스로 찾음
3. 결정트리의 장점과 약점
장점
1) 결과를 눈으로 따라가며 "왜 이렇게 예측했는지" 설명하기 쉬움 (화이트박스)
2) 스케일을 맞출 필요가 거의 없음 (값의 크기가 아니라 분기 기준만 봄)
약점
1) 가지를 너무 깊게 치면 훈련 데이터에만 맞는 과적합이 잘 생김
2) 데이터가 조금만 바뀌어도 트리 모양이 크게 흔들려 불안정함
4. 랜덤포레스트 - 트리를 숲으로
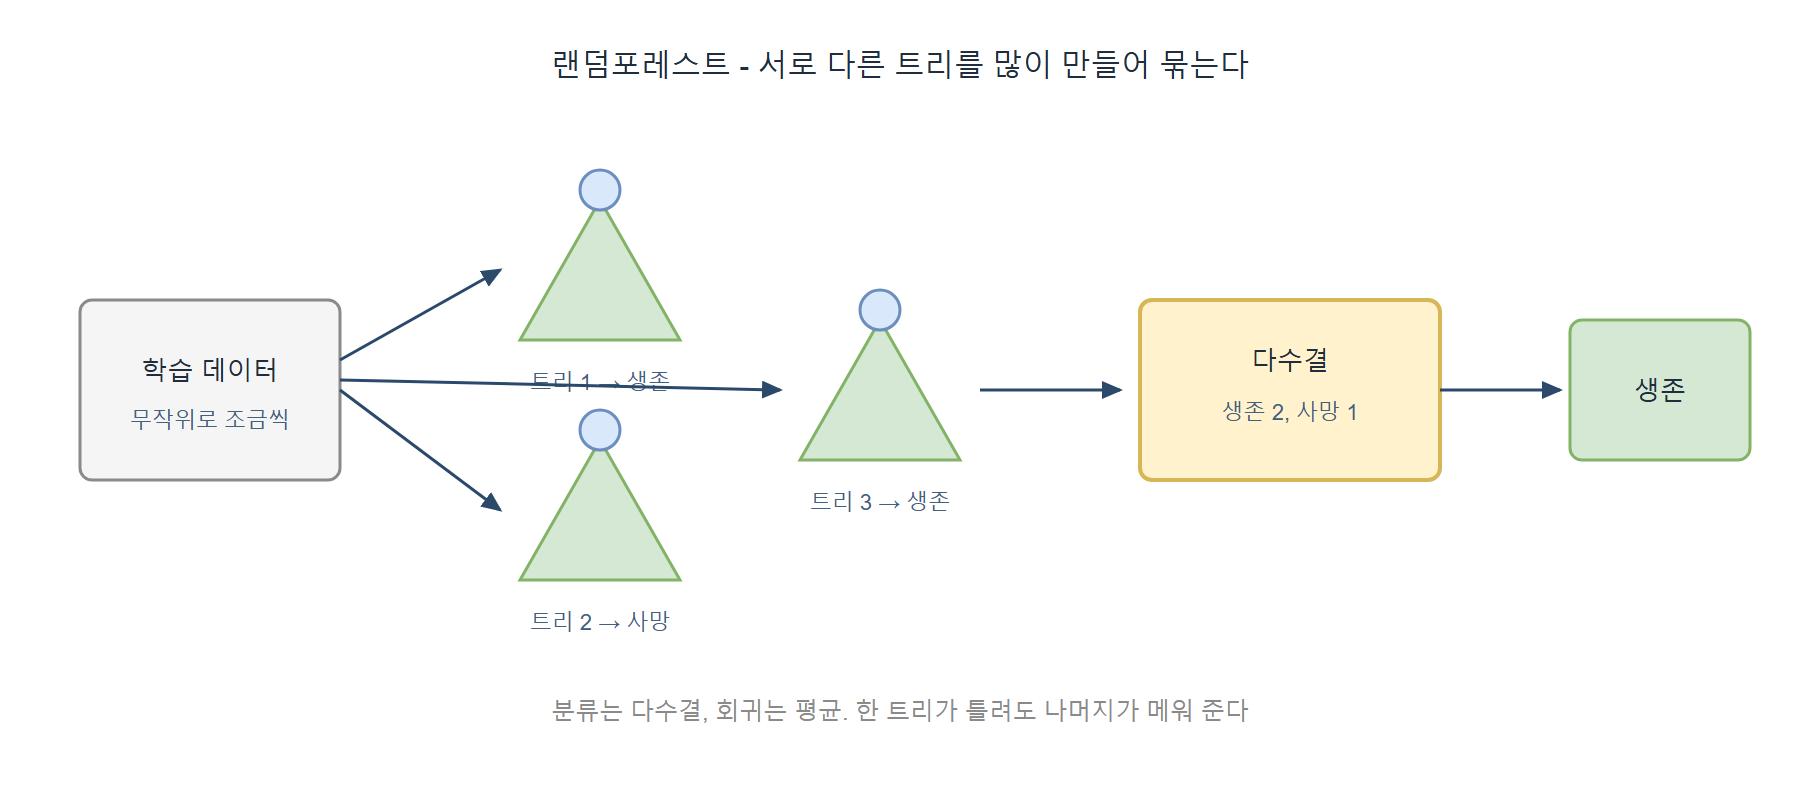
: 결정트리 하나의 불안정함을, 여러 트리를 묶어(앙상블) 보완한 모델임
: 데이터와 변수를 조금씩 다르게 뽑아 서로 다른 트리를 많이 만듦
: 분류는 다수결, 회귀는 평균으로 최종 예측을 냄
: 한 트리가 실수해도 나머지가 메워 줘서, 단일 트리보다 안정적이고 성능도 대체로 높음
5. 왜 "랜덤"인가
: 모든 트리가 똑같으면 묶는 의미가 없음 - 서로 달라야 실수가 메워짐
: 그래서 두 군데에 무작위를 넣음 - 각 트리에 데이터를 중복 허용으로 뽑아 주고(부트스트랩), 분기마다 변수도 일부만 후보로 줌
: 이렇게 트리들을 일부러 다르게 만들어, 다양한 관점이 모이게 함
: 다양성이 클수록 앙상블 효과가 커짐
6. 정리
1) 결정트리는 예/아니오 질문으로 데이터를 나눠 가며 예측하는 직관적인 모델임
2) 각 분기에서 불순도가 가장 많이 줄어드는 기준을 골라 가지를 침
3) 트리 하나는 설명하기 쉽지만 과적합과 불안정이 약점임
4) 랜덤포레스트는 서로 다른 트리를 많이 만들어 다수결, 평균으로 묶어 안정성과 성능을 높인 앙상블임
다음 머신러닝 글은 과적합과 정규화, 또는 교차검증을 정리해 볼 예정.
'AI > Basic' 카테고리의 다른 글
| 머신러닝 기초 (1) 지도학습과 비지도학습 (0) | 2026.09.30 |
|---|---|
| AI trend _ 추론 모델과 test-time compute (0) | 2026.09.23 |
| AI trend _ MCP(Model Context Protocol) 정리 (0) | 2026.09.21 |
| LLM 기초 (8) 프롬프트 엔지니어링 vs 컨텍스트 엔지니어링 - 에이전트 입문 (0) | 2026.09.19 |
| LLM 기초 (7) RAG 기초 - 검색을 붙여 환각 줄이기 (0) | 2026.09.18 |