지난 타이타닉 글에서 "정확도 80.4%"라고 했지만, 분류를 제대로 보려면 정확도 하나로는 부족하다.
이번 글은 혼동행렬에서 출발해 정밀도, 재현율, F1, ROC까지 정리한다.
1. 왜 정확도만으로는 부족한가
: 정확도 - 전체 중 맞힌 비율. 직관적이지만 함정이 있음
: 암 환자 1%를 찾는 문제에서 "모두 정상"이라 찍으면 정확도 99%가 나옴 - 정작 환자는 한 명도 못 찾았는데도
: 이렇게 한쪽이 드문(불균형) 문제에서는 정확도가 성능을 과대평가함
: 그래서 "무엇을 맞히고 무엇을 틀렸는지" 쪼개서 봐야 함
2. 혼동행렬 - 모든 지표의 출발점
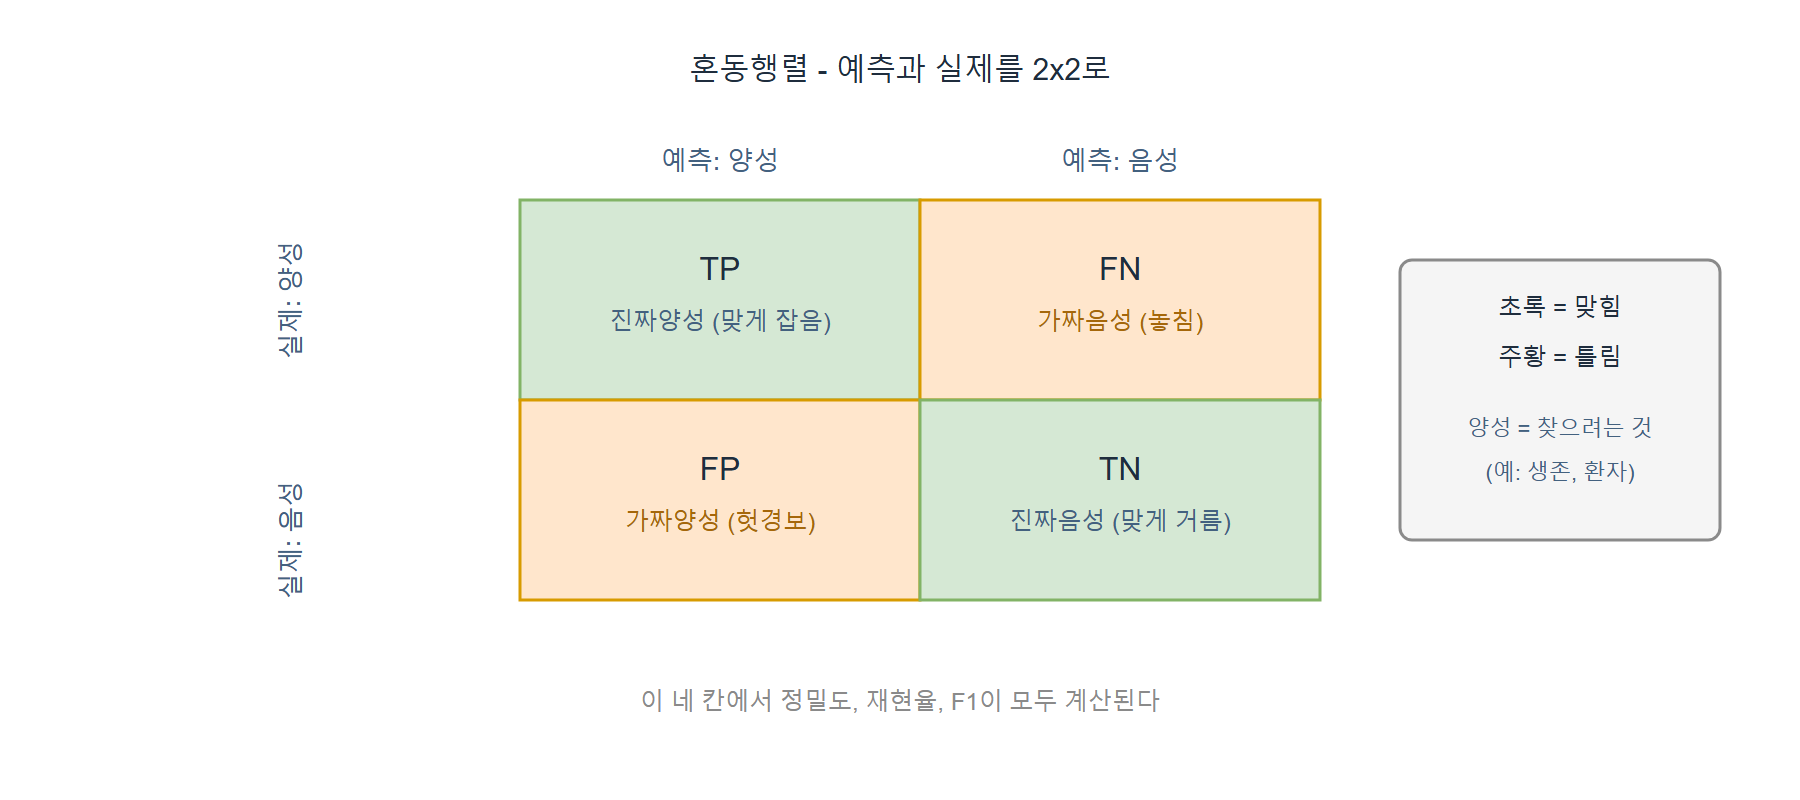
예측과 실제를 2x2로 나눠 보는 표임.
양성(찾으려는 것)을 기준으로 네 칸으로 나뉨.
: TP(진짜양성,TruePositive) - 양성을 양성이라 맞힘
: FP(가짜양성,FalsePositive) - 음성인데 양성이라 잘못 예측 (헛경보)
: FN(가짜음성,FalseNagative) - 양성인데 음성이라 놓침
: TN(진짜음성,TrueNagative) - 음성을 음성이라 맞힘
3. 정밀도와 재현율
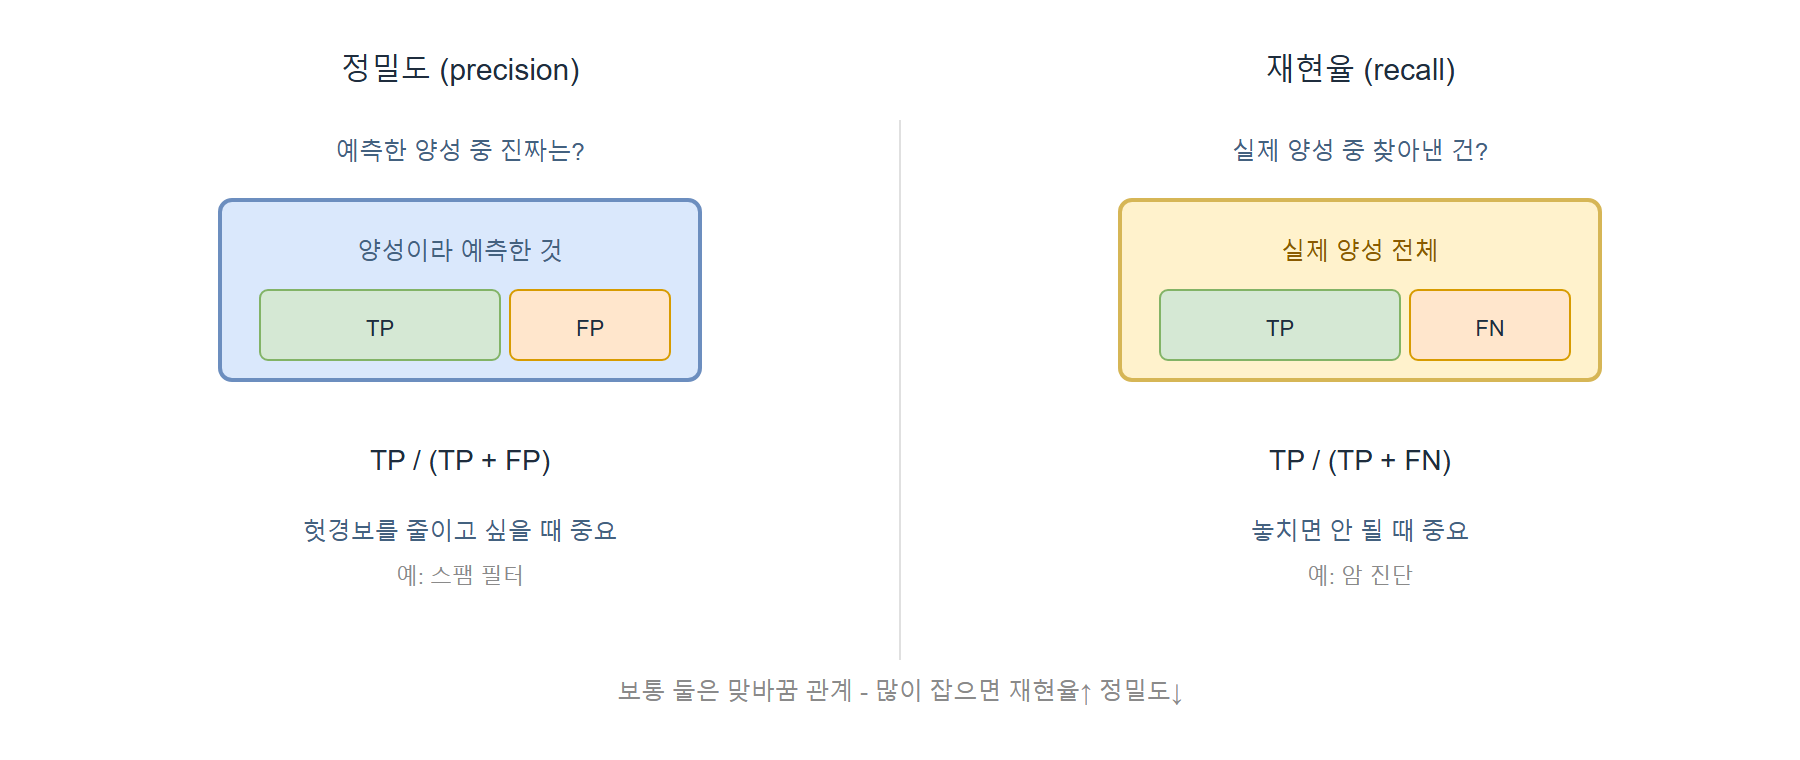
여기서 두 핵심 지표가 나옴. 둘은 보는 방향이 다름.
: 정밀도(precision) = TP / (TP + FP) - "양성이라 예측한 것 중 진짜 양성 비율". 헛경보를 줄이고 싶을 때 중요
: 재현율(recall) = TP / (TP + FN) - "실제 양성 중 찾아낸 비율". 놓치면 안 될 때 중요
: 예로 암 진단은 놓치면 치명적이라 재현율이, 스팸 필터는 정상 메일을 스팸으로 보내면 곤란해 정밀도가 더 중요함
: 보통 둘은 맞바꿈 관계 - 기준을 낮춰 많이 잡으면 재현율↑ 정밀도↓, 엄격히 잡으면 그 반대
4. F1 점수 - 둘의 균형
: 정밀도와 재현율을 하나로 합친 지표가 F1임
: F1 = 2 x (정밀도 x 재현율) / (정밀도 + 재현율) - 조화평균
: 둘 중 하나만 높아선 F1이 안 오름. 둘 다 고르게 높아야 함
: 그래서 불균형 데이터에서 정확도 대신 자주 쓰임
5. 타이타닉 예시로 계산해 보기
지난 글(로지스틱 회귀)의 예측 결과로 sklearn을 이용해 혼동행렬을 구해 봄.
from sklearn.metrics import confusion_matrix, precision_score, recall_score, f1_score

print(confusion_matrix(yte, pred))   # [[95 15]
                                     #  [20 49]]
print(precision_score(yte, pred))    # 0.766
print(recall_score(yte, pred))       # 0.710
print(f1_score(yte, pred))           # 0.737
혼동행렬 순서 - sklearn은 라벨을 작은 값(0)부터 줄 세움
: 행 = 실제값(위: 실제 0=사망, 아래: 실제 1=생존), 열 = 예측값(왼: 0, 오른: 1)
: 그래서 배열 순서는 [[TN, FP], [FN, TP]]임 - 맨 뒤 칸(아래 오른쪽)이 "실제 1 and 예측 1" = TP
: 양성(생존)을 1로 뒀고 1이 0보다 뒤라, 양성 칸들이 뒤쪽에 옴
직접 뜯어 보면
: TN=95, FP=15, FN=20, TP=49 (양성=생존 기준)
: 정밀도 = TP / (TP + FP) = 49 / (49 + 15) = 0.766
: 재현율 = TP / (TP + FN) = 49 / (49 + 20) = 0.710
: F1 = 2 x (0.766 x 0.710) / (0.766 + 0.710) = 0.737
: 정확도(80.4%)보다 낮게 나옴 - 생존을 20건 놓친(FN) 영향이 재현율에 드러남
6. ROC 곡선과 AUC
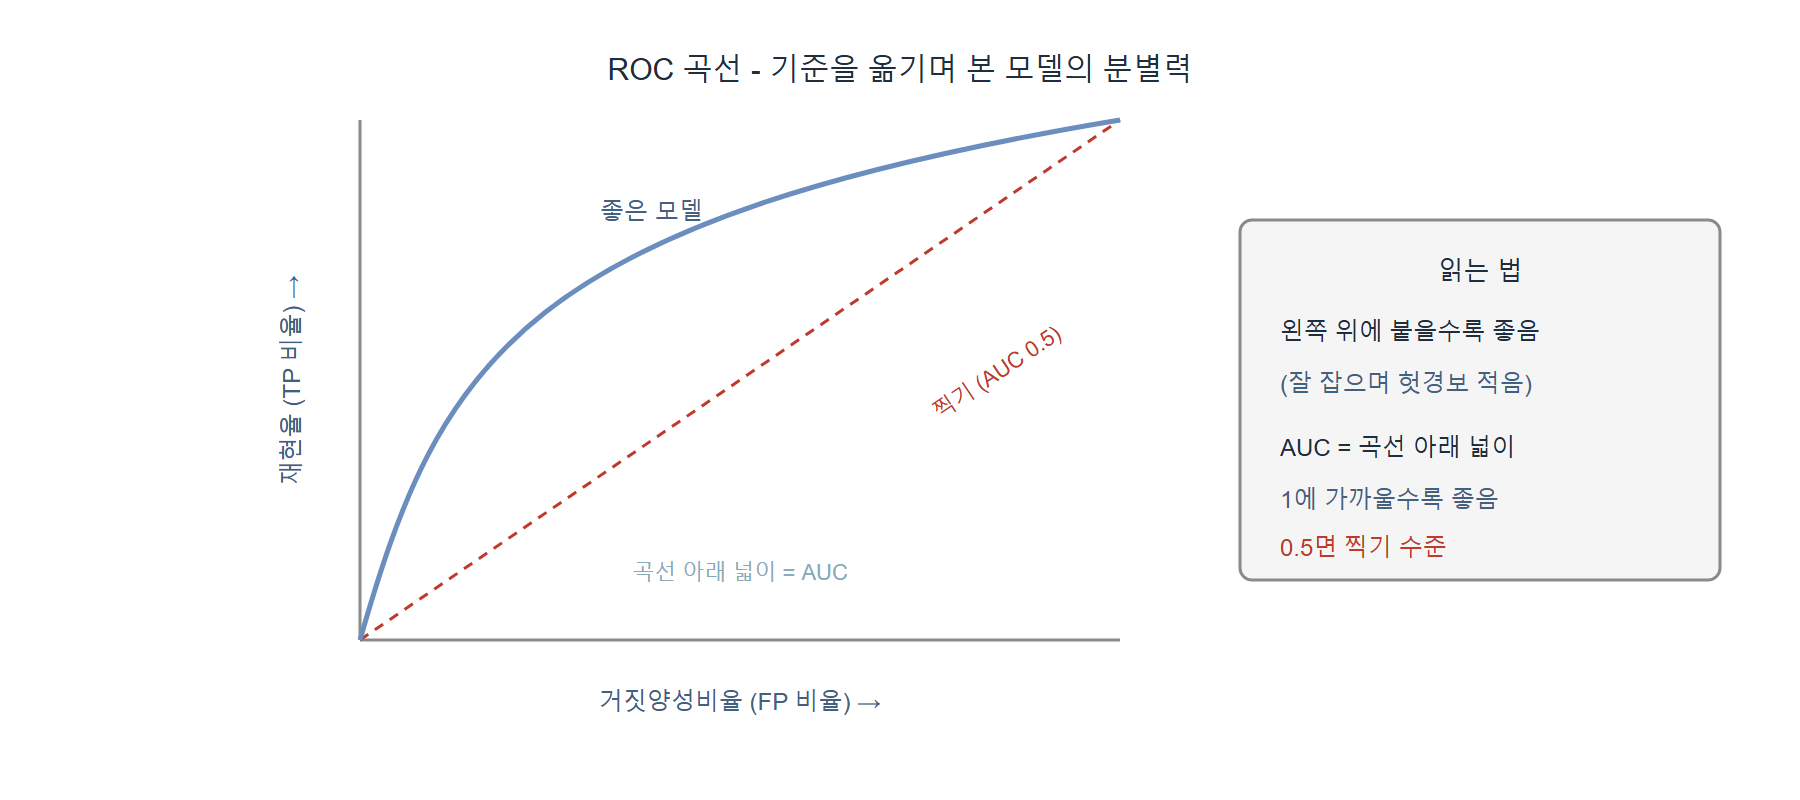
: 분류 모델은 보통 "생존 확률 0.5 이상이면 생존"처럼 기준(threshold)을 둠. 이 기준을 바꾸면 결과가 달라짐
: ROC 곡선 - 기준을 0부터 1까지 옮기며, 재현율(세로)과 거짓양성비율(가로)이 어떻게 변하는지 그린 곡선
: 왼쪽 위에 붙을수록 좋은 모델임 (잘 잡으면서 헛경보는 적음)
: AUC - 그 곡선 아래 넓이. 1에 가까울수록 좋고, 0.5면 찍기 수준임
7. 정리
1) 정확도는 불균형 데이터에서 성능을 과대평가할 수 있어, 혼동행렬로 쪼개 봐야 함
2) 정밀도는 "예측한 양성 중 진짜", 재현율은 "실제 양성 중 찾아낸 것" - 보는 방향이 다름
3) F1은 정밀도와 재현율의 조화평균으로, 둘이 고르게 높아야 오름
4) ROC 곡선과 AUC는 기준을 바꿔 가며 모델 전체의 분별력을 봄 - AUC가 1에 가까울수록 좋음
다음 데이터 글은 집값 예측(캐글), 또는 피처 엔지니어링으로 이어 갈 예정.
'데이터 > 데이터 분석 및 SQL' 카테고리의 다른 글
| SQL 문제풀이 (2) GROUP BY와 HAVING - 집계, 그룹별 조건 (0) | 2026.10.03 |
|---|---|
| 캐글 미니 프로젝트 (1) 타이타닉 생존 예측 - EDA부터 로지스틱 회귀까지 (0) | 2026.10.01 |
| SQL 문제풀이 (1) JOIN - INNER, LEFT, 자기조인 (0) | 2026.09.30 |
| 데이터 분석 (8) pandas 전처리 패턴 정리 - groupby, merge, pivot (0) | 2026.09.29 |
| 데이터 분석 (7) 데이터 시각화 원칙 - 어떤 차트를 고를 것인가 (0) | 2026.09.23 |